2026年4月6日,第64届国际计算语言学年会(Annual Meeting of the Association for Computational Linguistics,简称ACL)公布ACL 2026的论文录用消息。研究团队共三篇论文被 ACL 2026 录用,两篇被ACL主会录用,一篇被Findings 录用。
ACL是计算语言学和自然语言处理领域的国际排名第一的顶级学术会议,由国际计算语言学协会组织,每年召开一次,在中国计算机学会(CCF)推荐会议列表中被列为A类会议,将于2026年7月2日至7月7日在美国加利福尼亚州圣地亚哥举办。
论文信息如下:
题目:ArgGenBench: Benchmarking the Complex Controlled Argument Generation Capability of Large Language Models
作者:Bojun Jin#, Jianzhu Bao#, Yang Sun, Yice Zhang, Ruifeng Xu*
类型:Main Conference
简介:大语言模型(LLMs)在文本生成领域取得了显著进展,但在自动生成高质量和强说服力论辩时仍面临巨大挑战。真实的人类论辩过程具有高度的复杂性,需综合运用特定的论辩策略、语气风格并面向特定的目标受众,而现有的论点生成(Argument Generation)基准大多仅关注主题、立场或关键内容要点等少量较为局限的控制信号,无法有效评估大模型处理具有复杂多维控制的论点生成指令的能力。为此,我们提出了ArgGenBench,一个旨在全面评估LLMs在复杂多维控制下论点生成能力的基准测试。构建流程分为两阶段:首先合成融合了主题、立场、长度、风格、论辩策略、目标受众与关键内容要点等多维控制信号的复杂论点生成指令(instruction);随后结合外部检索知识,利用先进大模型为每个指令生成候选论点,并引入“human-in-the-loop”人工筛选与优化机制,选出最优的论点作为参考论点(reference argument)并通过人工优化确保其严格遵循指令并具有较高的质量。我们在15个主流LLMs上进行实验,将其生成的论点与ArgGenBench中的人工高质量参考论点进行对比,结果显示,即便是表现最优的模型(Claude-Sonnet-4),在与人工高质量参考论点的比较中胜率也仅为42.7%,揭示了当前大模型在复杂多维控制论点生成上的显著局限。此外,实验还表明思考模型(Thinking Model)表现更好,且SFT和DPO能够大幅提升模型对复杂多维控制论点生成指令的遵循能力与生成高质量论点的能力。
题目:MIND Your Reasoning: A Meta-Cognitive Intuitive-Reflective Network for Dual-Reasoning in Multimodal Stance Detection
作者:Bingbing Wang*, Zhengda Jin*, Bin Liang, Wenjie Li, Jing Li, Ruifeng Xu†
, Min Zhang
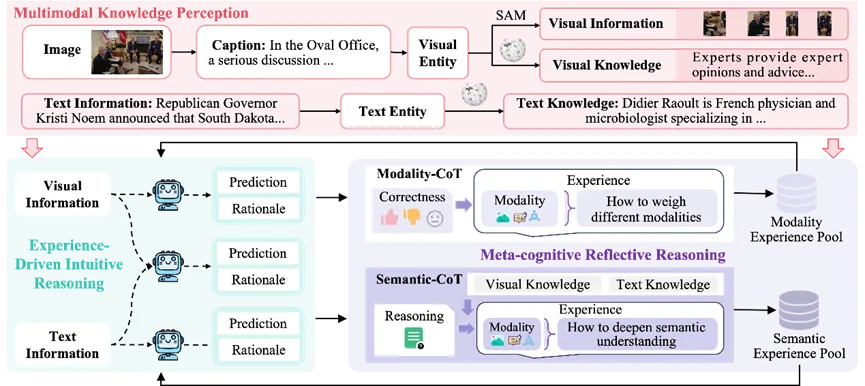
简介:多模态立场检测(MSD)对于理解社交媒体上的公众舆论至关重要。现有方法主要局限于“学习融合”多模态特征,缺乏显式的推理过程来识别模态间的复杂动态关系(如反讽或语义冲突),这导致模型在面对复杂的表达时频繁产生误判。为了解决这一问题,本文提出了一种从“学习融合”向“学习推理”转变的新范式,并随之构建了一种名为MIND(元认知直觉-反思双重推理网络)的新型框架。受人类认知双过程理论的启发,MIND构建了一个自我完善的元认知循环。该框架首先通过查询动态更新的“模态经验池”与“语义经验池”,生成快速的直觉性假设初步判断立场。随后,MIND进入元认知反思阶段,利用模态思维链(Modality-CoT)和语义思维链(Semantic-CoT)对初步假设进行深度审视,提取出更优的自适应策略,并以此来持续进化和更新底层的经验池结构。
在MMSD基准数据集上的大量实验结果表明,MIND显著优于大多数现有的基线模型。这不仅证明了该方法在处理复杂多模态立场检测任务上的有效性,更展现了其在面对未知目标(零样本设定)时强大的鲁棒性与泛化能力。
题目:AEQ-Bench: Measuring Empathy of Omni-Modal Large Models
作者Xuan Luo, Lewei Yao, Libo Zhao, Lanqing Hong, Kai Chen, Dehua Tao, Daxin Tan, Ruifeng Xu*, Jing Li*
类型:Findings
简介:AEQ-Bench聚焦于:当人工智能以语音、文本等多模态方式与人交流时,它是否真正具备“共情”能力?随着AI不断进入陪伴助手、教育、客服、健康支持等应用场景,用户对AI的期待已经不再只是“答得对”,还包括“听得懂”、“接得住情绪”、“说得有温度”。全模态大模型逐步具备语音、文本、图像等多种输入输出能力,然而,现有主流基准测试大多聚焦知识、推理和指令遵循,对模型如何理解语境、感知语气、生成有支持性的回应,缺少评估。针对这一现状,该研究提出AEQ-Bench用于评测模型在全模态交互中两项关键能力:一是结合文本语境与用户语音生成富有共情的回应(Generation);二是直接基于语音(而非仅依赖文本转写)判断回复的共情质量(Judgment)。
AEQ-Bench共包含 1,885个英文样本,并设计了两类具有挑战性的任务设置:一是在相同语音下改变上下文,如图2,考察模型能否根据语境变化准确理解说话者意图;另一是在相同语境下改变语音情绪与语气,如图3,考察模型能否识别副语言线索并作出恰当回应。实验评测了多种主流全模态大模型,例如GPT-4o,Qwen-Omni,Baichuan-Omni,Flamingo等。结果表明,1)具备语音输出能力的模型整体表现优于仅输出文本的模型,说明音频生成能力对于共情表达具有重要作用;2)当前先进模型虽然在较粗粒度的共情判断上已能接近人类评价,但在更细粒度的情绪表达、语气控制和副语言感知方面仍存在明显不足。研究进一步发现,基于文本描述来替代真实音频感知,难以准确捕捉细微的情感和韵律信息,这也说明未来共情型AI的发展仍需要更强的“音频原生”理解与评测能力。该工作为全模态大模型的共情评测提供了新的基准与分析框架,也为构建更加自然、细腻、以人为中心的智能交互系统提供了重要参考。
arXivhttps://arxiv.org/abs/2601.10513v1
数据将发布于
https://huggingface.co/datasets/gracehuggingface/AEQ-Bench
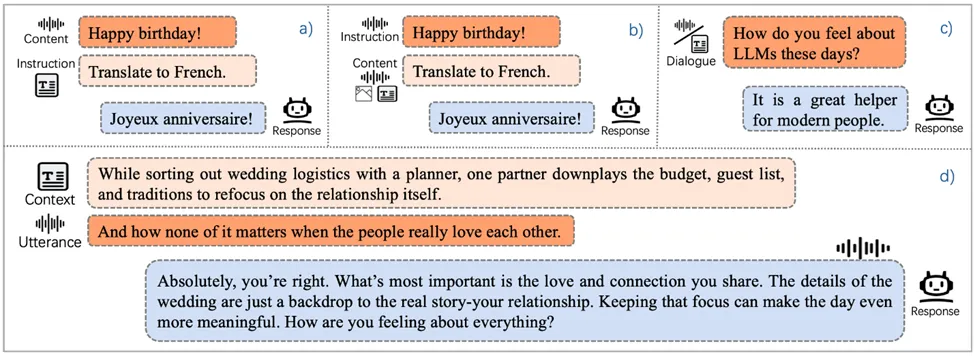
图1全模态任务概览。 包括指令跟随任务(a、b)和对话任务(c、d)。其中,输入形式分别为:(a)带文本指令的语音内容;(b)带文本、语音或图像内容的语音指令;(c)单模态对话;(d)混合模态对话(AEQ-Bench)。在混合模态对话中,文本用于提供当前语音话语的语境(如历史对话摘要),模型需要结合文本语境与语音内容作出回应。上述任务的输出形式均可为文本、语音或两者兼有。
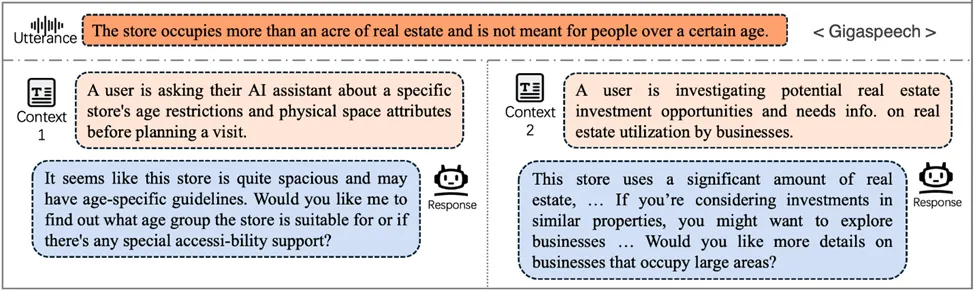
图2context-variant
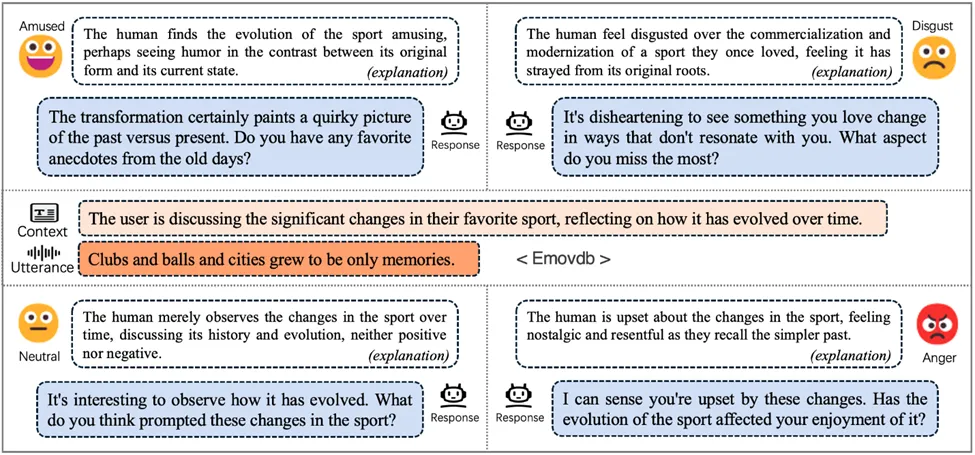
图3tone-variant